给应用接 LLM API:成本、限流与降级
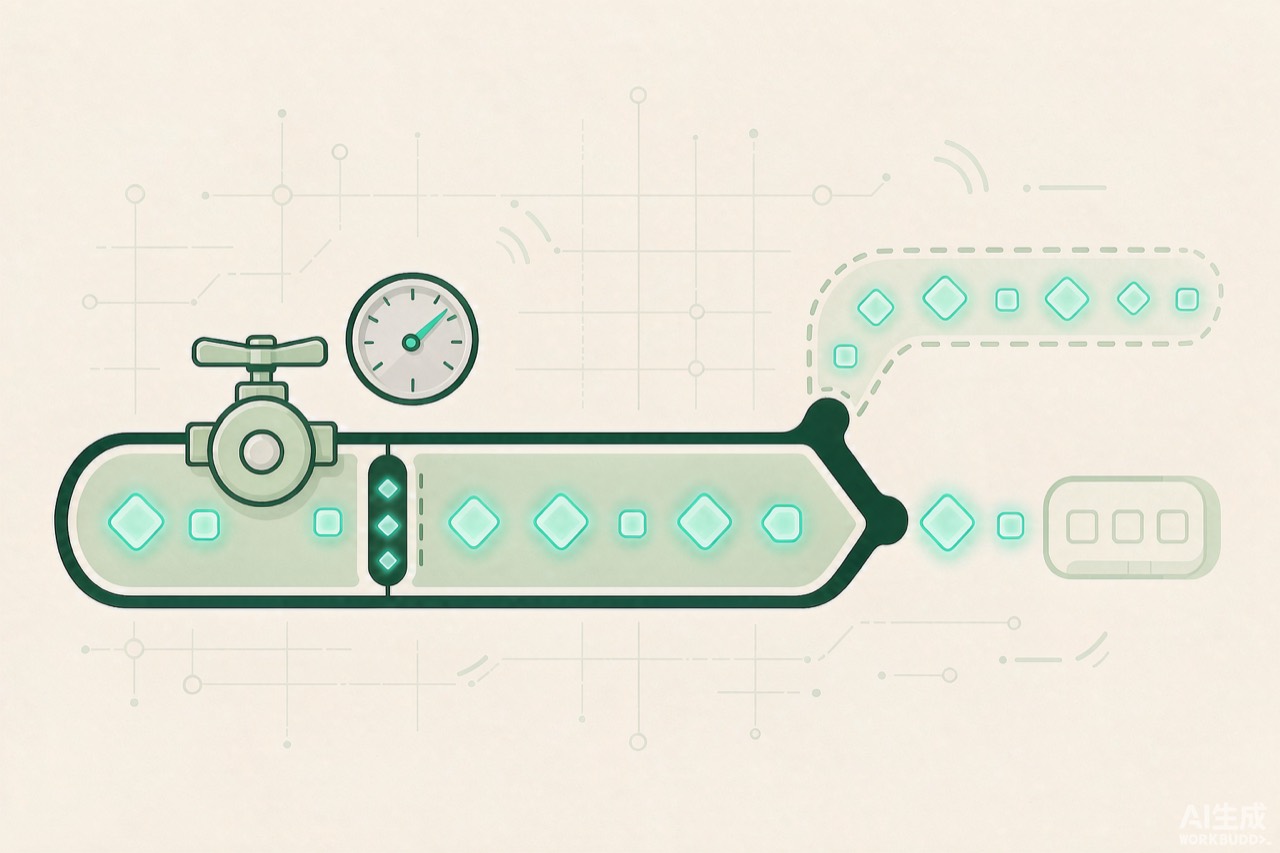
上线一个真正在用的大模型功能,工程量的大头不在调 API,而在限流、重试、缓存和降级。这篇整理一套可以直接抄的防线设计。
第一次把一个接了 LLM API 的功能推上线时,我以为最难的是把 prompt 写好。结果两周后账单寄来,我才发现真正的问题根本不在模型效果,而在工程:成本像漏水的龙头关不上、晚高峰一波流量直接把接口打挂、第三方一抖动我的服务就跟着雪崩。这篇是踩完这些坑之后,我对"如何稳稳地接一个 LLM API"的梳理,重点全在工程侧的可靠性和成本可控。
先说立场:把 LLM 当一个会偶尔抽风的外部依赖来设计,而不是一个永远在线的本地函数。这个心态一转,限流、降级、预算熔断这些看似繁琐的东西,就都有了存在的理由。下面从成本核算讲起,一路到上线后要盯的指标、以及怎么测试这套韧性,最后给一个可复用的 Python 封装示例。
配图:
成本核算:先把账算明白
很多团队上线后才发现"怎么这么贵",是因为从没认真算过账。LLM API 的成本结构有几个容易被忽略的点,不理清楚就会被账单吓到。
输入和输出的差价
API 通常输入 token 和输出 token 单价不同,而且输出往往更贵,有时贵出好几倍。如果你的场景是"长 prompt、短回答"(比如分类、抽取、打标签),成本大头在输入;如果是"短 prompt、长回答"(比如写文章、扩写),成本大头在输出。优化方向因此完全不同:前者要压输入长度、精简上下文;后者要约束输出上限、必要时用更短的小模型兜底。
我见过一个分类接口,system prompt 写了八百字还每次全发,日调用百万次,光输入就烧掉一大笔。后来把固定设定挪进缓存、按需裁剪,成本直接砍半。所以先搞清楚你的成本大头在哪,再动手优化,别瞎猜。
你算的 token 和供应商算的可能不一样
一个隐蔽的坑:你本地用 tiktoken 之类工具估算的 token 数,和供应商实际计费的对不上。不同模型的分词器不同,中文尤其容易估偏。我吃过亏,本地估算觉得单次几分钱,账单出来发现贵了快一倍,原因是中文在目标模型的分词下被切得更碎。正确做法是拿供应商返回的 usage 字段做真实记账,本地估算只用来做预算预警,别当结算依据。
多模态与缓存的账
如果你的场景带图片、音频,成本结构又变一层:多模态输入单价更高,而且很多缓存机制只认文本前缀,图片部分通常不缓存。这意味着"带图的问答"既贵又难省。我的处理是,能先用文本描述的就别塞图,必须带图时把图片尺寸压到最小,毕竟模型对超清图并没有额外收益,只是多烧钱。
缓存命中能救命
不少供应商提供 prompt 缓存:当你的 system prompt 或长上下文前缀稳定不变时,命中缓存的部分单价大幅降低,有时只有原价的零头。这意味着把不变的内容(角色设定、知识库前缀)放在 prompt 开头并保持稳定,能省下一大笔。
我有个项目的 system prompt 几百字几乎不变,开了缓存后这部分成本直接砍掉大半。但要注意缓存的"稳定性"要求:前缀一旦变动,缓存就失效。所以别在固定前缀里塞会变的用户内容,那会让你精心设计的缓存形同虚设。把稳定前缀和可变内容用清晰的分隔符分开,是让缓存长期生效的关键习惯。
批处理折扣
部分 API 支持离线批处理,价格比实时调用低不少,适合不要求秒回的任务:批量摘要、夜间跑的数据 enrichment、邮件草稿生成等。把"能等的"任务挪到批处理,是降本最直接的手段之一。
我的经验是,凡是延迟容忍度超过几分钟的任务,都值得进批处理队列。它不仅能省钱,还能把峰值流量削平,顺带缓解限流压力。
限流应对:429 不是错误是信号
限流(rate limit)是接外部 API 必修的一课。供应商按账号或按 key 限制单位时间请求数、token 数,超了就返回 429。处理不好,限流会从"偶发"变成"雪崩":你越重试,它越限你,最后整池子请求全在空转。
令牌桶与请求队列
客户端侧自己也要做限流,避免把上游打爆。令牌桶是最常用的算法:系统以固定速率往桶里放令牌,每个请求取走一个,桶空了就排队或拒绝。配合一个请求队列,把瞬时高峰平滑成稳定速率,对上游友好,也让自己更不容易吃 429。
我上线第一版没做客户端限流,结果高峰期一窝蜂并发,直接把供应商的配额打满,全员 429。后来加了一层令牌桶,把并发压到配额的安全线以下,429 几乎消失。客户端限流不是多此一举,是和上游和平共处的基本礼仪。
下面是一段最小可用的令牌桶实现,配合异步队列就能直接用:
import time
import threading

class TokenBucket:
    def __init__(self, rate: float, capacity: float):
        self.rate = rate            # 每秒补充的令牌数
        self.capacity = capacity    # 桶容量,允许短时突发
        self.tokens = capacity
        self.last = time.monotonic()
        self.lock = threading.Lock()

    def acquire(self, n: int = 1) -> bool:
        with self.lock:
            now = time.monotonic()
            # 按时间补充令牌
            self.tokens = min(self.capacity, self.tokens + (now - self.last) * self.rate)
            self.last = now
            if self.tokens >= n:
                self.tokens -= n
                return True
            return False  # 没令牌,调用方应排队或拒绝
桶容量允许短时突发,速率限制长期平均。把 rate 设成略低于供应商配额,你这一层就永远不会主动触发 429,问题消灭在客户端。
指数退避加重试
收到 429 不要立刻重试,那只会火上浇油。正确做法是带抖动的指数退避:等一小段、翻倍、再等,并加随机抖动避免大量请求同时苏醒。同时设上限,重试太多次就该放弃转入降级,别让一个请求无限期挂起拖垮调用方。
import time
import random

def backoff_sleep(attempt):
    # attempt 从 0 开始,退避幅度随次数指数增长
    base = 0.5 * (2 ** attempt)        # 0.5, 1, 2, 4, 8 秒...
    jitter = random.uniform(0, base)  # 加随机抖动,避免惊群效应
    time.sleep(base + jitter)
抖动(jitter)这一步很关键。没有抖动的话,一批同时被限流的请求会在同一个时间点集体重试,再次同时撞上限流,形成恶性循环。随机化唤醒时间能把这个尖峰抹平。
区分限流类型
429 之外还有别的状态要区别对待,乱重试和该重试的不重试,都是坑:
- 429:限流,适合退避重试,但别太频繁。
- 5xx:上游故障,可重试但间隔稍长,且要考虑是不是区域性故障。
- 400/401/403:请求本身有问题(参数错、鉴权失败、无权限),重试无意义,应直接报错并告警。
- 408/超时:网络层问题,可谨慎重试一次。
把错误分类,才能决定"能不能重试"。否则把本该失败的请求无限重试,只会放大故障、浪费配额,还掩盖了真实的代码 bug。
降级链路:让服务永远有回应
降级的核心思想:主模型不可用或太贵时,依次退到更便宜、更稳的备胎,直到礼貌拒绝。我设计的降级顺序是:旗舰模型 → 小模型 → 缓存结果 → 礼貌拒绝。每一级都在"牺牲一点质量换一点可用性"。
旗舰模型优先
默认走能力最强的旗舰模型,保证质量。只有它出问题或超预算时才往下掉。绝大多数正常流量都应该落在这级,降级是例外而不是常态。
小模型兜底
旗舰限流或超时时,退到便宜的小模型。质量下降但至少能答,适合"有总比没有好"的场景,比如生成一句话摘要、做个粗分类。小模型的限流配额通常更宽松、单价更低,做兜底性价比高。
这里有个细节:降级到小模型时,prompt 最好保持兼容(别用只有旗舰懂的特殊指令),否则降级反而答得更离谱。我吃过这个亏,给旗舰写的复杂指令喂给小模型,它直接无视,输出一塌糊涂。
语义缓存结果
如果这个问题近期被问过(相同或语义相似),直接返回缓存答案。很多产品里大量问题是重复的,缓存命中能同时省成本和延迟。对问答类产品,热门问题的缓存命中率往往不低,是降本的隐形大户。
下面是一段极简的语义缓存示意,用向量近似匹配代替精确哈希,能兜住"问法不同但意思一样"的重复:
def semantic_cache_get(query, cache, embed, threshold=0.92):
    q_vec = embed(query)
    for item in cache:
        # 余弦相似度超过阈值就视为同一问题
        if cosine(q_vec, item["vec"]) >= threshold:
            return item["answer"]
    return None

def semantic_cache_put(query, answer, cache, embed):
    cache.append({"vec": embed(query), "answer": answer})
注意缓存要设过期时间,尤其是有时效性的内容。语义缓存比精确哈希更实用,但多一次 embedding 调用,要在"省一次大模型调用"和"多一次 embedding"之间算清账,高频问题上稳赚,低频问题上意义不大。
礼貌拒绝
前面都失败时,返回友好提示而非抛错,保证用户体验不崩。记录失败以便告警。礼貌拒绝不等于"服务挂了",而是"这次我尽力了但没成",用户下次还能再来。
预算熔断与告警
成本失控比模型出错更隐蔽,因为它不报错,只是悄悄烧钱。等到账单出来,损失已经造成。所以预算控制要做在调用前,而不是账单后。
预算熔断
在调用前做预算检查:本小时/本天已花费是否逼近阈值。一旦超过,直接熔断该功能的模型调用,转入降级或关闭,避免账单爆炸。这步要放在封装层统一做,别散落在业务代码里,否则很容易漏掉某条路径。
熔断不是永久的,应该带自动恢复:到了下一个计费周期(比如新的一小时)重置计数,功能自动恢复。我建议阈值设两档:预警线(告警不熔断)和硬熔断线(直接停),留一点缓冲空间。
熔断之外:电路 breaker
预算熔断管的是"钱",另一种叫 circuit breaker 的模式管的是"上游健康"。如果连续多次调用失败(比如供应商区域故障),就先断开一段时间不再打请求,给上游恢复的机会,也避免自己的请求全堵在等待超时上。两者互补:预算 breaker 防烧钱,健康 breaker 防雪崩。
告警设计
关键告警至少有这几个,缺一不可:
- 单位时间花费超阈值:最直接的烧钱信号。
- 429 比例异常升高:可能限流配置不合理,或被人刷接口。
- 降级触发频率异常:说明主链路不健康,旗舰模型在频繁不可用。
- 单用户/单 IP 消耗异常:可能是循环调用 bug,也可能是恶意刷量。
- 缓存命中率骤降:可能缓存失效,成本会跟着涨。
告警要能触发到人,别只是写日志。我当初就是告警只进日志没人看,等发现时钱已经烧了一周。后来改成告警进即时通讯群,响应快了不止一个量级。
一个完整的封装示例
把上面这些揉进一个可复用的客户端里,业务代码就只管调用、不用操心工程细节。下面是一个 Python 封装示例,集成了重试、降级、预算检查,可直接作为你项目里 LLM 客户端的骨架:
import time
import random
from dataclasses import dataclass
from typing import Callable, Optional

class RateLimitError(Exception):
    pass

class ServerError(Exception):
    pass

@dataclass
class ModelConfig:
    name: str
    call: Callable                      # 实际调用该模型的函数,接受 prompt 返回文本
    cost_per_1k_in: float
    cost_per_1k_out: float

class LLMClient:
    def __init__(self, models, budget_per_hour: float):
        # models 按降级顺序排列:旗舰 -> 小模型
        self.models = models
        self.budget_per_hour = budget_per_hour
        self.spent_this_hour = 0.0

    def _check_budget(self, est_tokens: int, is_output: bool) -> bool:
        # 粗略估算本次花费,超预算则熔断
        unit = self.models[0].cost_per_1k_out if is_output else self.models[0].cost_per_1k_in
        est = est_tokens / 1000.0 * unit
        if self.spent_this_hour + est > self.budget_per_hour:
            return False
        return True

    def _call_with_retry(self, model, prompt, max_retry=4):
        for attempt in range(max_retry):
            try:
                return model.call(prompt)
            except RateLimitError:
                # 限流:指数退避,最后一次放弃交由降级处理
                if attempt == max_retry - 1:
                    raise
                base = 0.5 * (2 ** attempt)
                time.sleep(base + random.uniform(0, base))
            except ServerError:
                # 上游故障:轻量重试
                if attempt == max_retry - 1:
                    raise
                time.sleep(1 + random.uniform(0, 1))

    def complete(self, prompt, est_input_tokens=500, est_output_tokens=500) -> Optional[str]:
        for model in self.models:
            # 预算检查:输出那部分可能最贵,先看它
            if not self._check_budget(est_output_tokens, is_output=True):
                continue
            try:
                result = self._call_with_retry(model, prompt)
                # 记账,供后续预算判断使用
                self.spent_this_hour += (
                    est_input_tokens / 1000.0 * model.cost_per_1k_in
                    + est_output_tokens / 1000.0 * model.cost_per_1k_out
                )
                return result
            except Exception:
                # 该模型失败,进入下一个(降级)
                continue
        # 全部失败:礼貌拒绝,绝不抛错给用户
        return "抱歉,服务暂时繁忙,请稍后再试。"
这个封装把所有脆弱性收口在一处:业务方拿到的是 complete(),至于中间经历了几次重试、掉了几级模型、有没有超预算,它完全不必知道。我强烈建议任何接 LLM API 的项目,第一件事就是写这样一个封装层,而不是在业务代码里到处直接调 SDK。
需要补充的是,示例里 est_tokens 是预估的,真实计费以供应商返回的 usage 为准。生产环境应该把实际 usage 写回 spent_this_hour,让预算判断更准。另外 call 函数内部应当封装好鉴权和超时,别让一次调用无限挂起。更进一步,我通常会在这个客户端外面再包一层"供应商级 fallback":当 A 供应商整体不可用时,自动切到 B 供应商的同级别模型,把单点依赖也消除掉。
测试这套韧性
写完了不等于稳了。我吃过"代码看着对、上线就崩"的亏,所以现在会专门测韧性:
- 用 mock 让接口随机返回 429、500、超时,验证重试和降级真的触发,而不是只在文档里写着。
- 压测时故意把令牌桶速率调低,看高峰流量是不是被平滑、有没有请求被不合理地丢弃。
- 把预算阈值设极小跑一轮,确认熔断后功能真的停了、且周期到了能恢复。
韧性是靠"主动制造故障"验证出来的,不是靠读代码读出来的。这一步省了,迟早在生产环境补回来,而且代价更大。
上线后要盯的指标
功能上线只是开始,真正决定它健不健康的是这些指标。不看指标,你永远不知道系统是稳还是只是在赌:
- 单次调用平均成本与 P95 成本,警惕长尾。平均好看但 P95 爆掉,往往意味着某些长请求在偷偷烧钱。
- 429 与 5xx 比例,反映上游健康和你对限流的适配程度。比例抬头就要查,别等全员报错。
- 降级触发率,主链路出问题时它会先涨。突然升高说明旗舰模型扛不住了。
- 缓存命中率,直接关联成本和延迟。命中率掉了,成本和延迟会一起涨。
- 各模型用量占比,验证降级是否真的在兜底,还是压根没触发过。
- 端到端 P95 延迟,用户体验的硬指标,也是限流和降级效果的最终体现。
把这些画成看板,每天扫一眼,比事后看账单明智得多。我现在的习惯是周会上先放这张看板,再聊功能,问题总能早一周发现。
账单对账:别全信仪表盘
封装层里的预算计数只是"预估",真实账单以供应商为准,两者常有出入。我养成一个习惯:每月把自家按 usage 记的账,和供应商发票对账。出入通常来自三处:
- 分词差异:本地估算的 token 和供应商实算的不同,中文尤甚,前面提过。
- 缓存命中口径:你以为命中的前缀,供应商可能因为微小变动判为未命中,照原价计费。
- 隐藏项:有些供应商对特定功能(比如某些工具调用、特定模态)单独计费,文档里写得隐蔽。
对账不是为了挑刺,而是为了校准你封装层里的成本参数。发现长期低估,就把预估系数调高,让预算熔断更早触发,避免某天被真实账单吓到。这步我建议做成每月固定动作,而不是出事才查。
错误预算与 SLO
给 LLM 功能也定 SLO(比如"99% 请求在 5 秒内返回、降级率不超过 1%"),再配一个错误预算。错误预算就是"允许失败的次数",用完了说明系统不稳定,该先修稳定性而不是加新功能。
这对接 LLM 特别有用,因为上游故障你控制不了,但你能控制自己别在故障期雪崩。当降级率和 5xx 比例持续吃预算,就是信号:要么限流配错了,要么该加供应商 fallback 了。把"稳定性"也当成可度量的指标,而不是"应该没问题"的口头承诺。
别过度设计
最后泼一盆理性的冷水:上面这套不是每个项目都需要。如果你只是给自己写个脚本、日调用几十次,那加预算熔断、语义缓存、供应商 fallback 纯属自找麻烦,直接调 SDK 就好。工程复杂度的投入要看规模,当调用量、用户数、钱的真实风险上来之后,这些封装才值回票价。
我的经验线大致是:日调用过万、或涉及真实付费用户、或模型成本占毛利有存在感时,才值得上完整封装。在此之前,先把功能跑通,再随规模补盔甲。
上线前检查清单
把全文收成一个可直接照着勾的清单,接第一个 LLM API 前逐条过一遍:
- 是否有一个统一封装层,业务代码不直接调供应商 SDK。
- 封装层是否做了预算检查与熔断,并区分预警线和硬熔断线。
- 客户端是否带令牌桶限流,速率是否低于供应商配额的安全线。
- 重试是否带抖动的指数退避,且区分了 429/5xx/4xx 的处理。
- 降级链路是否齐备:旗舰 → 小模型 → 缓存 → 礼貌拒绝。
- 是否加了供应商级 fallback,消除单点依赖。
- 告警是否进人到群,而非只写日志,且覆盖花费、429、降级率、缓存命中率。
- 是否做了韧性测试:主动造 429、5xx、超时,验证降级真的触发。
- 是否约定每月账单对账,校准封装层里的成本参数。
这九条全勾上,你的 LLM 接入才算"工程上合格",而不是"能跑就行"。我早期漏了其中好几条,每漏一条都在生产环境以某种方式还了债。
最后提醒一句:这份清单是下限不是上限。业务越关键、流量越大、钱的真实风险越高,你该往上加的东西越多,多区域供应商、更细的预算维度、更完备的混沌测试。但底线是,只要接了 LLM API,上面九条就一条都绕不开,绕一条就预备在某天为它买单。
总结
接 LLM API 最难的从来不是"调通一个接口",而是让它在一个真实、嘈杂、会突发流量的生产环境里稳稳跑下去。把成本当成可约束的变量、把上游当成会抽风的依赖、把降级当成默认设计,你的服务才不会在第一次流量高峰时垮掉。
若你正准备接第一个 API,我的建议是:先写一个带预算检查和降级的封装层,再让任何业务代码碰模型。这层看似啰嗦的代码,会在你最狼狈的时候救你一命,比如那个我经历过的、因为没限流而全员 429 的深夜。
最后一句忠告:LLM API 不是普通函数,它贵、会限流、会抽风、还会悄悄烧钱。用对待数据库和第三方支付的谨慎去对待它,你的线上生活会比别人安稳得多。这套封装和习惯一旦建立,后面接第二个、第三个模型都是复制粘贴的事,早期那点啰嗦,会在每一次平稳度过流量高峰时连本带利地还给你。