从提示词工程到上下文工程
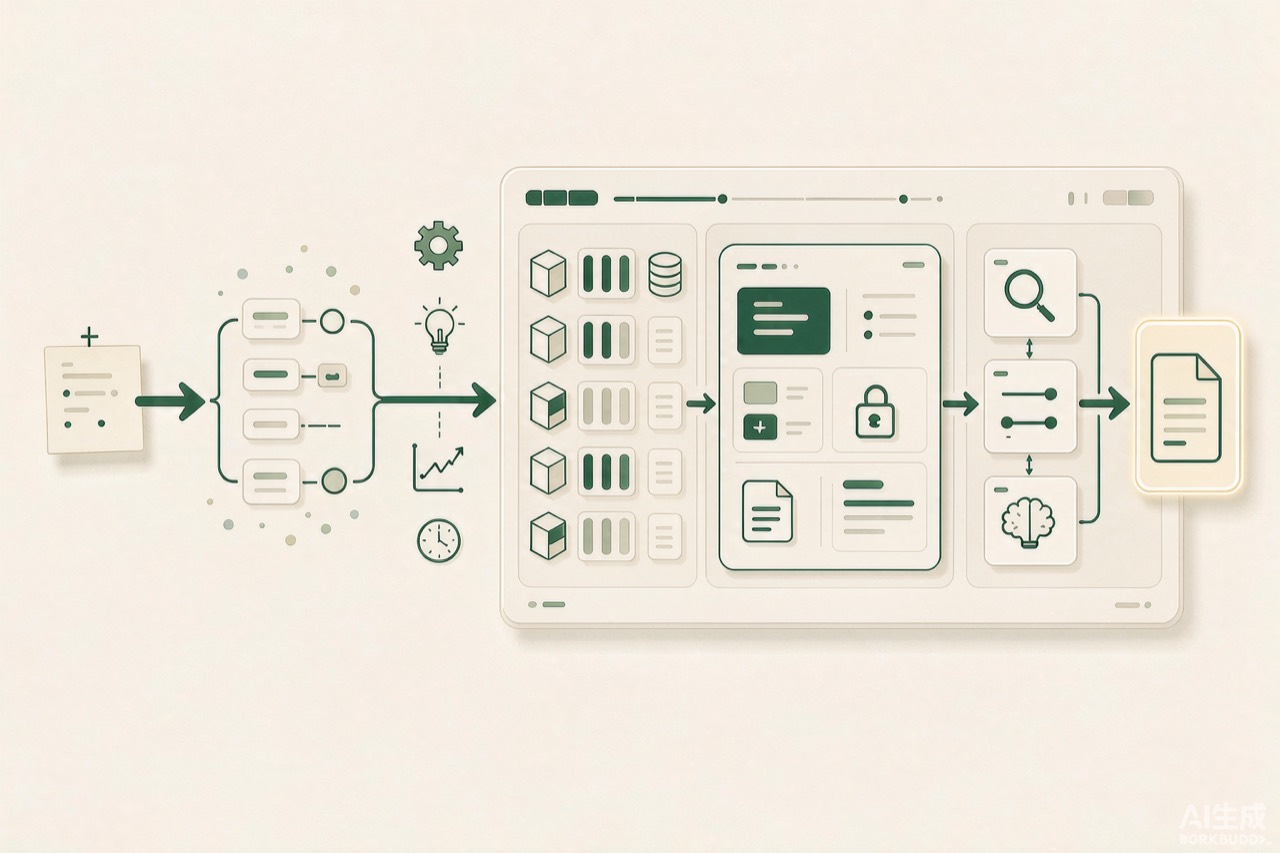
过去一年最明显的变化:写好一句指令带来的提升越来越有限,而“给模型看什么”——文档、示例、历史、工具结果的组织方式——成了效果的主要变量。
去年我们团队接手一个内部知识库问答项目,起初它跑得很"标准":一句系统提示,加上用户的问题,丢给大模型。准确率低得离谱,返工返到怀疑人生。我们试过换更强的模型、把提示词写得越来越长,效果却只在原地踏步。直到有一天我把整段对话历史、检索回来的文档片段、以及工具调用的返回一并打印出来读了一遍,才恍然大悟:问题从来不是"那一句话"不够聪明,而是我们塞给模型的整个上下文,本身就是一团乱麻。
我越来越确信一个判断:2026 年再去谈"提示词工程",这个说法已经过时了。对真实业务系统而言,真正决定上限的是上下文工程(context engineering):也就是如何系统性地组织、筛选、排序与校验送进模型窗口的一切信息。提示词只是上下文里最小的一块拼图,而拼图的其他四块,才是大多数线上系统翻车的真正现场。
这篇文章想聊的是,当你的系统不再是一个一次性问答的玩具,而是一条持续运行、会调用工具、会记忆、会检索的流水线时,你怎么把"上下文"当作一等公民来对待。下面这些结论不是从书里抄的,是我们把一个线上问答系统从六成好评做到八成以上好评、又拦下过好几次"模型升级实则退化"的事故之后,真刀真枪磨出来的。如果你正在做 Agent、RAG 或者任何带状态的 LLM 应用,希望这些能帮你少走弯路。
上下文到底是什么
很多人把"系统提示词"等同于上下文,这是第一个认知陷阱。在我现在的架构里,一次推理所消费的上下文,至少由五部分拼成:
- 系统提示(system prompt):定义角色、约束、输出格式的"宪法"。
- 对话历史(conversation history):多轮里用户与助手的来回,以及被压缩过的旧轮次。
- 检索内容(retrieved context):向量库或关键词召回的文档片段,即 RAG 注入的部分。
- 工具结果(tool results):函数调用拿回来的 JSON、数据库查询结果、API 响应。
- 记忆(memory):跨会话沉淀的用户偏好、长期事实、上次未完成的事项。
这五块不是简单相加。它们之间会互相覆盖、互相矛盾、互相抢注意力。模型其实是在一个有限的、带噪的窗口里做"注意力分配":你已经给了什么、放在什么位置、彼此是否一致,远比单次措辞重要。我见过太多团队花两周雕琢系统提示里的一句措辞,却对检索回来的一大坨无关文档视而不见,本末倒置。
一个容易被忽视的点是:这五块的"可信度"是不同的。系统提示是可信的(你写的),检索内容可能过时,工具结果可能字段缺失,记忆可能记错了。我在上下文里会给不同来源打隐式标记,让模型知道"哪段是权威、哪段要存疑"。这不是玄学,而是在提示里明确写"以下检索内容可能不准确,若与系统规则冲突以系统规则为准"。一句话,就把来源优先级定下来了,模型不再需要自行猜测。
上下文预算与优先级
大模型窗口有"上下文预算"这个概念,但它不等于"能塞多少 token"。真正稀缺的是模型的注意力。注意力是一种会被稀释的资源:你每多塞一段噪声,真正关键的信息被注意到、被准确使用的概率就下降一点。这也是为什么有些任务在 8k 窗口里答得比 128k 窗口里更好,不是模型变笨了,是它在一大池无关的上下文里"迷路"了。
所以我给自己定了一套优先级排序,从"必须被看到且被遵循"到"能省就省":
- P0 输出格式与硬性约束:必须放在最稳定、最靠前的位置,且保持极简。
- P1 当前轮次的用户真实意图:永远最新,紧跟在约束之后。
- P2 直接相关的检索结果/工具结果:按需注入,且带明确来源标记。
- P3 对话历史中影响当前决策的关键事实:通常要压缩,而不是全量回放。
- P4 长期记忆与偏好:低密度注入,做成"提示"而非"指令"。
一个反直觉的体会:历史对话往往是最该被压缩的部分。用户三句话前说"我偏好中文回复",这值得记住;但他前两轮的寒暄、犹豫、重复提问,对当前决策几乎零贡献,全量保留只会稀释注意力。我见过最夸张的案例是有人把整段历史原样回灌,结果模型把用户半小时前的玩笑当成了当前需求,闹了笑话。
# 一个简单的上下文预算分配器:把不同来源的 token 按预算裁剪
from dataclasses import dataclass

@dataclass
class ContextBudget:
    total: int = 32000          # 模型窗口上限(含输出预留)
    output_reserve: int = 4000  # 留给模型生成的空间
    system: int = 1500
    history: int = 8000
    retrieve: int = 9000
    tools: int = 6000
    memory: int = 1500

    @property
    def usable(self) -> int:
        return self.total - self.output_reserve

    def plan(self) -> dict:
        # 硬性部分先占,再按比例松弛分配软性部分
        fixed = self.system + self.memory
        remaining = self.usable - fixed
        # 历史与检索是弹性大户,超了就压缩
        elastic = self.history + self.retrieve + self.tools
        if elastic > remaining:
            scale = remaining / elastic
            self.history = int(self.history * scale)
            self.retrieve = int(self.retrieve * scale)
            self.tools = int(self.tools * scale)
        return {
            "system": self.system,
            "history": self.history,
            "retrieve": self.retrieve,
            "tools": self.tools,
            "memory": self.memory,
        }

budget = ContextBudget()
print(budget.plan())
这个脚本的价值不在于它多精确,而在于它把"优先级"从口头约定变成了一个可执行、可观测的数字。每次上线前跑一遍,你就能知道"检索部分是不是又把历史挤没了"。我后来还加了一个断言:P0 系统提示必须 100% 进入最终上下文,否则直接报错阻断发布。这种"硬保障"比靠人盯靠谱得多,也避免了某次重构把约束不小心截断的事故。
当上下文预算见底:砍哪一块
优先级排好了,现实却是预算永远不够分。线上高峰时,检索召回想多塞、历史想保留、工具结果又膨胀,三块一起超额,弹性分配器一压缩,往往先把历史压没了,用户刚说过的偏好就丢了。所以光有优先级顺序还不够,还得有一套"预算见底时的取舍纪律"。
我的经验是:先保 P0 硬约束和 P1 当前意图,这两块绝不妥协;再保 P2 里"和当前问题直接相关"的检索与工具结果,宁少勿杂;P3 历史和 P4 记忆在冲突时优先被压缩,而且压缩必须带摘要,而不是一丢了之。一次我们遇到检索和工具结果同时膨胀,我选择砍掉两段相关性弱的检索、保留工具关键字段,回答立刻回正,这说明预算紧张时,"相关性"比"数量"更该被当成裁剪的第一标准。
预算裁剪的本质是一次次微型决策:每次都问"这段信息如果没了,模型会不会答错"。会,就留;不会,就砍。把这道问题变成肌肉记忆,你的上下文才不会在流量高峰时散架。
长上下文的真相
厂商都在宣传 128k、200k 甚至更长的窗口,但落地一年我最深的体会是:窗口长不等于能用好。模型对超长上下文的中后段存在明显的"Lost in the middle"现象,放在一大段文字中间的关键信息,被注意到的概率显著低于开头和结尾。所以即便窗口够大,我也倾向于把信息做小、做精、做对位,而不是一股脑塞满。
这也解释了为什么 RAG 至今没被"直接把整个知识库塞进上下文"取代:不是塞不下,是塞进去模型也用不好。检索的本质不是省 token,是帮模型把注意力聚焦到对的几段上。我做过一个对照实验:同一批问题,把整本文档(约 4 万字)直接塞进去,对比只塞 top-3 相关片段,后者准确率反而高出一截。证据很朴素,但足够说服团队别再迷信"全量上下文"。
检索结果的重排与去重
RAG 最容易翻车的地方,是召回了一大堆"看起来相关其实没用"的片段,然后全塞进上下文。我的做法分三步:
- 召回阶段放宽(多召回,避免漏),重排阶段收紧(用更强的重排模型把真正相关的顶上来)。
- 去重:同一文档的相邻段落常常高度重复,保留其一即可。
- 截断:只取 top-3 到 top-5,且每片控制长度,超长做要点提取。
# 检索结果的重排与裁剪(简化)
def prepare_retrieval(query: str, raw_hits: list) -> list:
    # raw_hits: [{"text":..., "score":...}]
    reranked = rerank_model(query, raw_hits)      # 重排,不只看向量相似度
    deduped = dedupe_by_overlap(reranked)          # 去掉重叠度高的片段
    top = deduped[:5]
    return [trim_to_sentences(h["text"], max_sent=8) for h in top]
这段代码里最容易被忽略的是 dedupe_by_overlap,很多团队只重排不重排相邻冗余,结果上下文里一半是同一段话的不同截取,纯属浪费预算。
工具结果的字段裁剪
工具返回常常是个大 JSON,比如查一笔订单,后端返回三十个字段,而模型当前只需要"状态"和"预计送达时间"两个。原样塞进去有两个害处:一是占预算,二是模型可能被无关字段带偏(比如看到"退款次数"多就胡乱建议退款)。
# 工具结果裁剪:只保留下游需要的字段
NEED = {"order_status", "eta", "tracking_no"}

def trim_tool_result(raw: dict) -> dict:
    return {k: v for k, v in raw.items() if k in NEED}

# 更稳的做法:用 schema 声明,缺失字段显式补 null
def safe_trim(raw: dict, schema: list) -> dict:
    return {k: raw.get(k) for k in schema}
我给团队的硬规则是:任何工具结果进上下文前,必须经过一次 safe_trim。这条规定上线后,因"模型被工具冗余字段带偏"导致的错误肉眼可见地少了。
常见反模式
下面这几条,都是我或我同事真刀真枪踩过的坑,每一条都对应过一次线上事故。
什么都往里塞
最常见也最致命。RAG 召回了八段文档,全塞进去;工具返回了一个 6000 字的 JSON,原样粘贴;用户十年前的偏好也翻出来。结果是关键信息被淹没,模型开始"幻觉式拼接":因为它分不清哪段才是你真正要它用的。
我的经验法则:检索召回默认只取 top-3 且做去重;工具结果必须做字段裁剪,只保留下游需要的字段,绝不全量 dump。一次我们接第三方物流 API,返回里有一百多个字段,我最初全量塞进上下文,模型反而开始胡编物流状态;裁剪到 6 个关键字段后,准确率立刻回升。
关键信息埋在底部
我曾把"必须只使用中文回答,不要使用英文术语"这条硬性约束,写在系统提示的最后一个段落。结果模型在长对话里经常忽略它,因为越靠后的指令,在注意力机制里越容易被前面的长检索内容"冲淡"。后来我把所有硬约束抽到提示最顶部,并以单独区块呈现,违反率肉眼可见地降了下来。
注意力不是均匀分布的。模型对开头和结尾更敏感,对长上下文的中段最不敏感。把最不能违反的东西,放在它最看得到的地方。
顺序错乱
一个具体例子:我们曾经先放工具返回的原始数据,再放"请基于以上数据回答"的指令。模型有时会直接复述数据而非按要求分析。调整成"先指令、后数据、再强调一次指令要点"的夹心结构后,遵循度明显提升。顺序不是排版习惯,是信号强度。
另一个顺序坑是"检索材料在用户问题之前"。模型读到检索材料时还不知道用户要问什么,于是它对这些材料的"预处理"是盲目的。改成先给问题意图摘要、再给材料,模型命中率更高。这点和人类阅读习惯一致:先知道要找什么,再看材料才看得准。
矛盾指令
系统提示说"你是简洁的助手,回答不超过三句话",业务规则里又写"请详细解释每一个步骤"。两种指令打架时,模型会在两轮之间反复横跳,用户体感就是"精神分裂"。我现在的做法是:把所有约束集中到一处做冲突检测,上线前人工过一遍"有没有两条规则在抢同一件事"。
更隐蔽的矛盾来自"记忆"和"系统提示"打架。比如记忆里记了"用户喜欢详细版",系统提示写"默认简洁"。谁赢?没定义就会随机。我现在的约定是:系统提示 > 本轮业务规则 > 长期记忆 > 历史偏好,并在提示里显式声明这个优先级,避免模型自行裁决。
单位与时区陷阱
这是个小但高频的坑:工具返回的时间是 UTC,系统提示却假设是北京时间,模型不转换就直接回复"明天送达",用户按本地时间理解就错了。我现在的做法是:工具结果里的所有时间、金额、单位,都在注入前统一换算并标注,比如"eta: 2026-09-23T08:00:00+08:00(北京时间)"。标注清楚了,模型几乎不再混淆。
把上下文当代码来 diff 和 review
这是我认为最该被推广的工作流。我们对待上下文,应该像对待一段会频繁改动的代码:
- 版本化:每次调整系统提示、记忆注入策略,都提交一条带说明的变更,不要只在对话框里试。
- diff:上线前后,把实际拼装出的上下文导出,逐段对比"这次多了什么、少了什么、挪了哪儿"。
- review:把一段真实上下文当成 PR 来审,问自己,"如果我是模型,我看到这段会先注意什么?哪些是噪声?"
# 把一次真实请求的上下文落盘,方便事后 diff
import hashlib, json, time, os

def dump_context(trace_id: str, parts: dict):
    os.makedirs("/tmp/ctx_traces", exist_ok=True)
    payload = {
        "trace_id": trace_id,
        "ts": time.time(),
        "parts": parts,  # {"system":..., "history":..., "retrieve":...}
    }
    path = f"/tmp/ctx_traces/{trace_id}.json"
    with open(path, "w") as f:
        json.dump(payload, f, ensure_ascii=False, indent=2)
    # 生成一段指纹,便于对比两个版本是否实质变化
    sig = hashlib.md5(
        json.dumps(parts, ensure_ascii=False, sort_keys=True).encode()
    ).hexdigest()
    return path, sig

# 在请求链路里调用,回放时直接 diff 两次的 json
有了这套落盘,我曾发现一个诡异问题:某次部署后检索质量没变,但回答变差了。diff 之后才看到,有人在重构时不小心把 retrieve 拼到了 history 之前,顺序错乱导致工具结果被忽略。这种 bug 靠看跑分根本发现不了,只有把真实上下文摊开对比才现形。
我还加了一个"上下文健康度"检查:每次拼装后自动统计各来源占比,若检索占比超过 60% 就告警,经验上这意味着噪声可能压过了指令。这种量化护栏比人工 review 更稳,也让我能在凌晨被告警叫醒时,第一眼就知道是哪块上下文膨胀了。
压缩与摘要的工程实践
历史对话和超长检索材料都需要压缩。我的做法是两层:
- 近期轮次保留原貌,远期轮次用模型先摘要成"事实列表",再注入。
- 检索材料过长时,先按段落切片,用相关性模型重排,只保留 top 段,必要时对保留段再做一次"要点提取"。
# 历史对话的滑窗压缩
def compress_history(turns: list, keep_recent: int = 4):
    recent = turns[-keep_recent:]
    old = turns[:-keep_recent]
    if not old:
        return recent
    # 把旧轮次压成事实摘要,而不是丢弃
    summary = summarize_old_turns(old)
    return [{"role": "system", "content": "历史摘要:" + summary}] + recent
注意这里我没有"丢弃"旧信息,而是"转译"为高密度事实。直接丢弃有时会漏掉用户早前埋下的关键前提。压缩的目标是降噪不丢关键信息。我们曾经图省事直接丢旧轮次,结果模型忘了用户开头说的"我只看中文资料",后面推了一堆英文链接,被投诉。从那以后,压缩必带摘要。
上下文工程与微调的关系
有人问:上下文工程能不能被微调替代?我的看法是,它们是两件事,互补不互斥。微调改变的是模型"参数里的能力",上下文工程解决的是"这次具体该用哪些信息"。同样是退款场景,微调能让模型更懂退款术语,但"这次这个用户的历史订单、当前政策版本、工具查回的状态"只能靠上下文临时喂进去。所以别指望微调能替你做上下文组织,该省的上下文工程一步都省不掉。
before / after 示例
下面是一段"坏"的上下文组织(已脱敏简化),和改造后的版本。
before:
系统提示:你是一个助手。
[用户历史 12 轮,含大量寒暄与重复追问]
[检索召回 8 段文档,未排序未去重]
系统提示补丁:请只用中文,详细分步骤回答。
[工具原始 JSON 6000 字]
用户:帮我对比 A 方案和 B 方案的成本。
after:
系统提示(顶部,硬约束集中):
- 仅使用简体中文,不使用英文术语。
- 输出分步骤,每步不超过两句话。
- 只依据下方"检索材料"与"工具数据"作答,不得编造。
- 来源优先级:系统规则 > 业务规则 > 记忆 > 历史。

[工具数据(已裁剪为所需字段,时间统一标注时区)]
[检索材料 top-3,按相关度排序,每段标注来源]

用户当前问题:帮我对比 A 方案和 B 方案的成本。
(历史仅保留一条压缩过的偏好:用户关注长期运维成本)
差别不在"写得更华丽",而在信息的筛选、排序、去噪与来源定级。我们上线这版后,同一批测试问题的人工好评率从约六成提升到八成以上,而且幻觉引用外部知识的次数明显减少。更关键的是,后续每次模型更新,我们都能靠这套结构快速判断"是模型变差了,还是上下文组织该调了"。
上下文工程的可观测性
上下文组织做得好不好,不能只靠"感觉回答变好了"。我把可观测性拆成三层,每一层都能在出问题时快速定位:
- 拼装层:每次请求记录各来源 token 占比、是否触发裁剪、硬约束是否完整进入。占比异常立刻告警。
- 使用层:记录模型实际引用了哪些来源(通过让其输出引用片段),看关键信息有没有被用上。
- 结果层:对关键任务做小流量评测,对比上下文改版前后的准确率曲线。
这三层我庆幸早早就建了。有一次评测准确率莫名下滑,拼装层显示"检索占比从 35% 涨到 58%",顺藤摸瓜发现是重排模型把一批不相关文档顶了上来。没这层监控,我可能又会去无端怀疑模型变差。
与 Agent 多轮循环的血缘
如果你的系统是个 Agent,会反复调用工具、多轮决策,上下文工程就更复杂一层:每一轮的工具结果都会追加进上下文,轮次越多,上下文越臃肿,越容易触发前面说的种种反模式。我的经验是给 Agent 上下文加一个"每轮收口"动作,
# Agent 每轮收口:压缩已完成的工具调用,只留结论
def compact_agent_context(rounds: list, keep_last: int = 2):
    recent = rounds[-keep_last:]
    earlier = rounds[:-keep_last]
    compressed = []
    for r in earlier:
        # 旧轮次只留"做了什么、结论是什么",丢弃原始大 JSON
        compressed.append({
            "action": r["action"],
            "result_summary": summarize(r["raw_result"]),
        })
    return compressed + recent
这一步直接决定了长任务 Agent 会不会"后面忘了前面"。我们一个需要十几次工具调用的分析任务,加了收口后,最终结论的连贯性肉眼可见地提升,之前常常出现"后几轮和前几轮结论打架"的尴尬。
什么时候上下文工程救不了你
写到这里也得泼盆冷水:上下文工程不是万能药。有几种情况,你再怎么整理上下文也白搭,该换模型或该微调时就别硬撑:
- 模型本身能力天花板太低,连"读懂检索材料"都做不到,整理再多上下文也补不上理解力缺口。
- 任务需要的知识模型训练时根本没见过,且检索又补不进来(比如纯内部未文档化的潜规则),上下文只能喂已知信息。
- 输出需要稳定的结构化格式但模型就是学不会,这时候该考虑微调或后处理解析,而不是无限堆提示。
认清边界很重要,否则你会陷在"是不是我上下文没组织好"的自我怀疑里,迟迟不敢承认"是模型不行"。我们团队有个默契:上下文优化三轮还没起色,就暂停,先怀疑模型能力,而非继续内耗在上下文上。
我的取舍
最后说点我自己的判断,不一定对,但经得起我们的业务检验:
- 别迷信"更长更全更好"。在上下文工程里,减法比加法更难也更重要。
- 把硬约束当 P0 资产守护,把历史当可压缩缓存,把检索当按需供给,把工具结果当必须裁剪的输入。
- 来源可信度要显式声明,别让模型在冲突时自行裁决;单位、时区、语言这类小陷阱,统一在注入前处理掉。
- 窗口长不等于用得好,聚焦比堆量有效;RAG 的价值是聚焦注意力,不是省 token。
- 永远保留"真实上下文落盘 + diff"的能力。它是你对抗"改了没效果、不知道为什么"的唯一抓手。
- 提示词工程不会消失,但它只是上下文工程的一个子集。2026 年还只盯着那一两句话的人,会越走越窄。
上下文工程不是把更多东西喂给模型,而是替模型把世界整理清楚,再安静地递到它手边。这件事,值得你像对待核心代码一样认真。