Agent 元年:从会聊到会干活
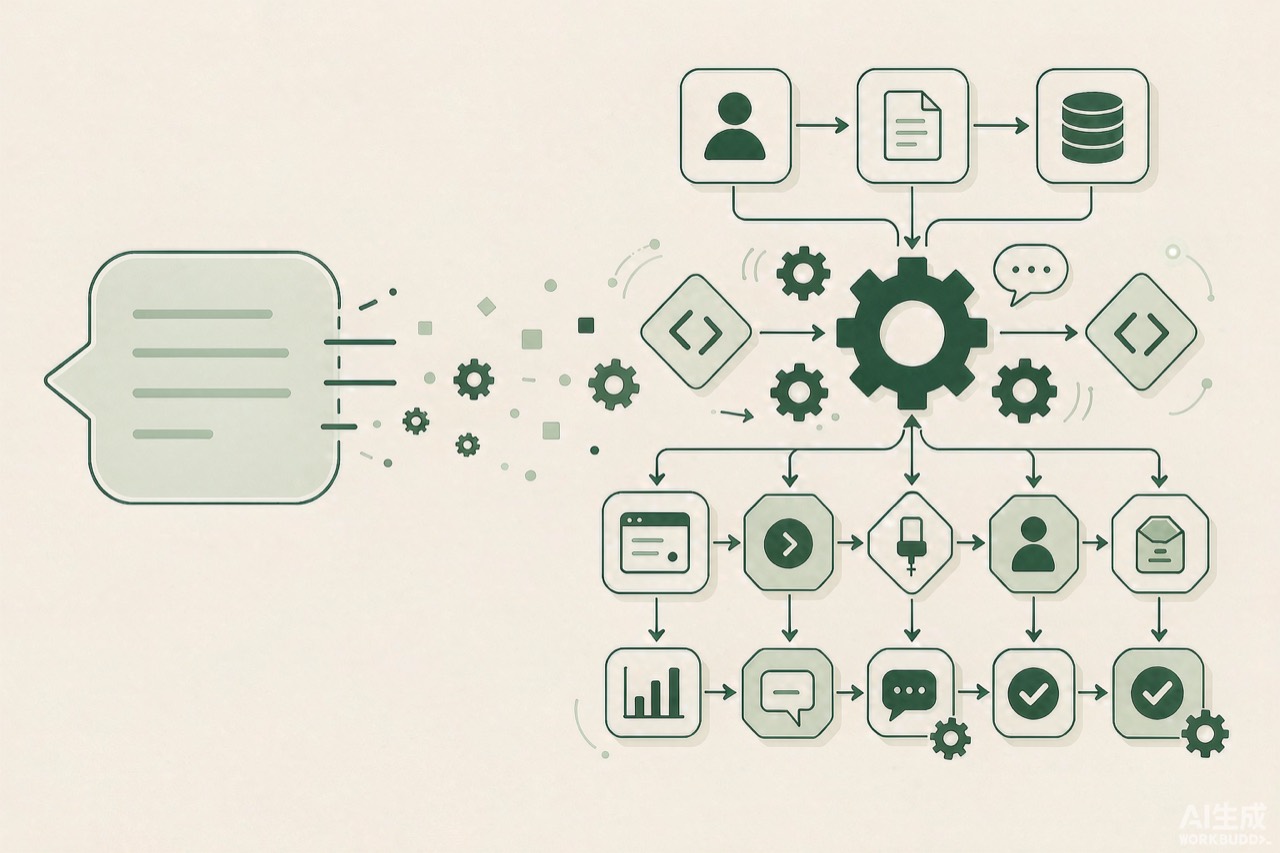
行业竞争的重心正在从模型跑分转向 Agent 落地交付。怎么理解这次重心转移,以及为什么“稳定交付”比“聪明”更难。
去年这个时候,我还在朋友圈里转一篇又一篇「ChatGPT 会取代程序员」的爽文。到了 2026 年的秋天,风向明显变了:大家不再纠结模型「会不会聊天」,而是追问它「能不能把一件事办成」。这个词就是 Agent。可我发现一个尴尬的事实,绝大多数被冠以 Agent 之名的 demo,本质上还是个会调接口的聊天框,离「会干活」差得很远。
我之所以想写这篇,是因为我自己在落地项目时反复踩坑。最初我以为只要给大模型套一层 function calling,再接上几个内部 API,就能宣称「我们做了个 Agent」。结果上线两周,工单里全是「它答非所问」「卡死在循环里」「改坏了生产数据还停不下来」。这些事故逼我重新想清楚一件事:Agent 不是聊天机器人的一个开关,而是一整套关于「自主执行」的工程范式。
这篇我想用第一人称,把我理解的 Agent 到底新在哪里、循环怎么跑、什么时候该停、以及哪些场景根本不值得上 Agent,老老实实讲一遍。代码我会用尽可能贴近真实工程的 Python 伪代码,重点不在能直接复制运行,而在于把结构讲透。我还会把这一年来踩过的坑,以及我最终沉淀下来的取舍,一并摊开。配图之后,我们正式开始。
聊天机器人为什么不算 Agent
先说一个容易得罪人的判断:只做「输入文本、输出文本」的东西,无论它用了多强的模型,都是聊天机器人,不是 Agent。区别在于「是否有手」,以及「是否对结果负责」。
聊天机器人是被动的。你问一句,它答一句,答完这一轮就结束了。它不会主动去查数据库,不会在发现答案不对时自己重试,也不会在完成一系列动作后确认目标是不是真的达成了。它的世界只有对话窗口那一方天地。它和真实系统之间,隔着一道墙:它的输出只是建议,落地还要靠人。
Agent 不同,它运行在一个「环境」里。这个环境可以是文件系统、浏览器、数据库,也可以是你们公司的工单系统和代码仓库。Agent 能读取环境状态,能对环境施加动作,并且它能根据动作产生的反馈,决定下一步做什么。一句话:聊天机器人生产文本,Agent 生产「状态的变化」。
我见过最典型的误判,是把「带工具的对话」当成 Agent。比如一个能查天气的助手,你问「北京今天天气」,它调用 weather_api 然后念出结果,这依然是一次性的请求-响应,没有规划,没有多步,没有对失败的自我修复,更没有终止条件的自觉。把它叫 Agent,是把门槛降到了地板上。真正的分水岭是:当第一次尝试失败时,它是就此交还给你,还是自己换条路再试一次。
还有一层常被忽略的区别是「目标导向」。聊天机器人围绕「这一句话」服务,Agent 围绕「那件要办成的事」服务。句子之间有边界,事情之间没有。Agent 必须跨越多轮、跨越工具、跨越失败,持续朝目标收敛。这种持续性,才是它最贵的部分。
Agent 的基本循环:感知-规划-行动-观察
剥掉所有花哨的包装,我认为一个合格的 Agent 核心就是四件事的循环:感知(Perceive)、规划(Plan)、行动(Act)、观察(Observe)。这个循环在很多框架里被叫做 ReAct(Reason + Act),但我不想被某个框架的名字绑死,因为它描述的是一种结构,而不是某个库。
感知是 Agent 读取环境当前状态的过程。它可能是把用户的最新指令、历史上下文、以及工具返回的结果,拼成这一次决策所需的「全貌」。很多新手会忽略感知这一步的代价:上下文窗口是有限的,你不能无限地把所有历史塞进去,必须做摘要和筛选。感知质量直接决定规划质量,垃圾进垃圾出在这里同样成立。
规划是 Agent 最核心的能力,也是大模型真正发光的地方。拿到感知到的信息后,模型要判断「我现在离目标还差什么」「下一步最该做哪个动作」。这里的关键词是「判断」,不是「执行」。规划输出的是一组候选动作或一个具体的工具调用方案。好的规划会权衡代价:是先检索还是先试错?是一步到位还是小步快跑?这些权衡,正是 Agent 比固定脚本聪明的地方。
行动是 Agent 把规划变成对环境的影响。调用 API、写文件、执行命令、发消息,这些都是行动。行动意味着副作用,意味着风险,所以这一步必须有边界和护栏。我习惯在行动层做一道「权限闸门」:哪些工具任何情况都能调,哪些要审批,哪些干脆不许碰,必须在代码里写死,而不是指望模型自觉。
观察是行动之后回看环境有没有按预期变化。接口返回了什么?文件写成功了吗?测试通过了吗?观察的结果会重新进入感知,成为下一轮循环的输入。闭环就这样转起来。没有观察,循环就是瞎转;观察不准,Agent 就会在错误的前提上越走越偏。
我越来越倾向于一个观点:Agent 的智能不在模型本身,而在「循环 + 环境反馈」这个结构上。模型提供判断力,循环提供持续性,环境反馈提供真实感。三者缺一不可。很多人把 Agent 当成「更强的模型」,其实是把因果搞反了。
一个朴素的循环骨架
这段伪代码把四步串起来,先不纠结工具怎么注册,只看节奏:
# 极简 Agent 主循环骨架(伪代码,重在结构)
def run_agent(goal, environment, max_steps=20):
    memory = []          # 感知累积的记忆
    state = environment.snapshot()  # 初始感知

    for step in range(max_steps):
        # 感知:把目标、当前状态、历史拼成 prompt
        context = build_context(goal, state, memory)

        # 规划:模型决定下一步动作
        plan = model.decide(context)

        # 终止:模型认为目标已达成,主动退出
        if plan.is_done:
            return plan.final_answer

        # 行动:执行被允许的工具
        result = environment.execute(plan.action)

        # 观察:把结果写回记忆,刷新状态
        memory.append((plan.action, result))
        state = environment.snapshot()

    return None  # 超过步数仍未完成
注意这里我特意留了 max_steps 和 is_done 两个出口。没有它们,这个循环就是个无限转的轮子,迟早把算力、钱和你的生产环境一起烧穿。我在早期版本里偷懒没写步数上限,结果一个解析 bug 让 Agent 在十分钟内烧掉了平时一天的 token 预算,那张账单我到现在都记得。
终止条件:Agent 什么时候该停下来
如果说感知-规划-行动-观察是 Agent 的引擎,那终止条件就是刹车。我踩过的最惨的坑,就是上线一个没有好好设计终止条件的 Agent,它在一个「重试发券」的任务里,因为每次都误判「还没发成功」,生生给同一个用户发了四十多张优惠券,直到财务那边对账才发现。
终止条件至少有三类,工程上通常要组合使用:
- 目标达成:模型自己判断任务完成,返回最终结果。这是最理想的情况,但也最不可靠,因为模型可能过早自信,也可能「幻觉式完成」:以为干完了其实没干。
- 步数上限:硬性兜底,超过 N 步一律停止。这是对「失控」的最后防线,必须存在,且阈值要基于任务的真实复杂度来定,不能拍脑袋。
- 人工确认:当动作涉及不可逆副作用(删库、发钱、对外发消息)时,强制暂停等待人类点头。这不是怯场,是对生产环境最基本的尊重。
我在实践中给终止加了一条额外规则:连续两轮观察「状态无实质变化」就停。很多死循环的本质,是 Agent 以为自己在推进,其实每次行动都被环境拒绝或覆盖,状态原地踏步。检测到这种「空转」,比单纯数步数更聪明,也能更早发现卡点。
真正成熟的 Agent 系统,刹车往往比油门复杂。你要花在「让它停下来」上的代码,可能比「让它跑起来」还多。这恰恰是它和玩具 demo 的分水岭。我甚至建议:在写第一行规划逻辑之前,先把终止和熔断写清楚。
记忆与上下文:被忽视的第三只手
很多教程把 Agent 讲成「循环 + 工具」,却对记忆轻描淡写。但在真实任务里,记忆往往才是决定成败的暗线。这里说的记忆,不是模型权重,而是你在循环之外为它准备的「外部大脑」。
我把记忆分成三层:
- 短期记忆:当前这一轮循环能直接看到的上下文,包括目标、最近几步的观察和动作。它受窗口限制,必须精简。
- 中期记忆:这次任务跑到现在沉淀下来的摘要,比如「已经排除了 A、B 两个方案,因为它们会破坏兼容性」。它让 Agent 不重复踩坑。
- 长期记忆:跨任务沉淀的知识,比如你们项目的代码规范、历史决策理由。它让 Agent 越来越「懂行」。
实践中最坑的一点是:直接把全部历史塞进上下文,既贵又容易让模型被早期噪声带偏。我后来改成每轮只保留「结构化摘要 + 最近 K 步原文」,其余压缩进中期记忆。成本降了,效果反而更稳。
# 记忆裁剪的简化示例(伪代码)
def build_context(goal, memory, recent_k=5):
    summary = summarize(memory[:-recent_k])      # 早期记忆压成摘要
    recent = memory[-recent_k:]                   # 近期保留原文
    return format_prompt(goal, summary, recent)
这段小代码看着简单,但它背后的取舍很关键:你放弃了「全量上下文」的奢侈,换来了「可控、便宜、不跑偏」的稳健。对长任务来说,这笔交易非常划算。
从一次性对话到有状态工作流
把上面那个循环放进真实业务,立刻会撞上一个问题:对话是无状态的,但工作是有状态的。用户上午提了个需求,下午回来问「进度怎么样了」,你的 Agent 得记得它干到哪了、改了哪些文件、卡在哪个环节。
这就是从「一次性对话」到「有状态工作流」的关键变化。我的经验是,必须把 Agent 的运行时状态显式地模型化,而不是指望藏在 LLM 的上下文里,上下文是易逝的,一次重启、一次超时就会丢干净。
- 任务状态:pending / running / blocked / done,对应工作流的不同阶段。
- 中间产物:Agent 每步产生的草稿、检索结果、临时文件,要有落点,最好带版本。
- 决策日志:它为什么选这个动作、放弃了什么,必须可追溯,否则出了事无法复盘,也无人可问责。
- 人工节点:把「等待人类」也作为一种合法的状态,而不是异常。卡在人工节点是常态,不是故障。
我后来把 Agent 跑的任务当成一条普通的「工作流实例」来存,有唯一 ID、有状态机、有事件流水。这样它既能在后台跑几分钟甚至几小时,也能随时被用户查询、被运维干预。这个视角切换之后,很多原本棘手的问题(断点续跑、并发控制、审计)都顺了。一个意外的收获是:排障时我不再需要去翻模型日志猜它在想什么,直接看事件流就知道它哪步卡住了。
失败重试与人工接管
Agent 一定会失败。不是「可能」,是「必然」。模型会幻觉、工具会超时、环境会变更、上游会悄悄改字段。所以失败处理不是附加功能,而是 Agent 的一等公民,得从第一天就设计进去。
重试要讲策略,不能无脑循环。我一般分三层:
- 瞬时错误(网络抖动、限流):指数退避后自动重试,通常两三次就能过,不必惊动人类。
- 可恢复错误(参数不对、权限临时不足):先尝试自我修正,比如让模型根据报错重新规划参数,再执行。这一步最能体现 Agent 相对脚本的优势。
- 不可恢复错误(依赖服务挂了、需求本身矛盾、触及风险红线):立刻转入人工接管队列,别硬撑,硬撑只会把小问题养成大事故。
人工接管的设计经常被忽视,但它决定了一个 Agent 产品是「能用」还是「敢用」。我的做法是为每个任务维护一个「接管通道」:当 Agent 连续失败、或动作超过风险阈值时,把当前上下文、已做动作、卡住的原因打包推给人类。人处理完,可以把结果写回,Agent 从断点继续。这比「全部推翻重来」成本低得多,也保住了用户信任。
我现在的信条是:把 Agent 当成一个不太靠谱但手脚很快的实习生。你要做的是给它清晰的目标、安全的边界,以及一个随时能喊「老板你来」的按钮。你越敢放手,越说明你的按钮够稳。
最小可运行 Agent 循环(Python 伪代码)
前面都是骨架,这里给一个更接近工程的版本,带工具注册、风险分级和人工接管。为了聚焦逻辑,我把模型调用和环境都抽象成接口。注意看我怎么把前面说的每一条原则落进代码。
# 一个更接近工程的 Agent 循环示例(伪代码)
from dataclasses import dataclass

@dataclass
class Action:
    name: str
    args: dict
    risk: str = "low"   # low / high

class NeedsHumanApproval(Exception):
    def __init__(self, action):
        self.action = action

class Environment:
    def __init__(self):
        self.tools = {}        # 工具名 -> 可执行函数
        self.risk_of = {}      # 工具名 -> 风险等级

    def register(self, name, fn, risk="low"):
        self.tools[name] = fn
        self.risk_of[name] = risk

    def execute(self, action: Action):
        if action.risk == "high":
            raise NeedsHumanApproval(action)   # 高风险动作强制人工接管
        return self.tools[action.name](**action.args)

def run(goal, env: Environment, max_steps=15):
    memory = []
    stuck_count = 0
    last_state = None

    for step in range(max_steps):
        ctx = build_context(goal, memory)      # 感知(含记忆裁剪)
        plan = model.decide(ctx)               # 规划

        if plan.is_done:
            return plan.answer                 # 终止:目标达成

        action = plan.action
        try:
            result = env.execute(action)       # 行动(含护栏)
        except NeedsHumanApproval as e:
            human = ask_human(e.action)        # 人工接管
            if human.approved:
                result = env.tools[e.action.name](**e.action.args)
            else:
                return "aborted by human"

        memory.append({"action": action.name, "result": result})

        # 空转检测:状态无变化则累加,连续三次则停
        new_state = env.snapshot()
        if new_state == last_state:
            stuck_count += 1
            if stuck_count >= 3:
                return "stuck, need human"
        else:
            stuck_count = 0
            last_state = new_state

    return "timeout"   # 终止:步数上限
这段代码里我埋了三个工程要点:风险分级、异常即托管、空转检测。它们单独看都不复杂,但少了任何一个,系统在真实环境里都会很快翻车。我最想强调的是 NeedsHumanApproval 这个异常,它把「不敢做的事」从正常流程里剥离出来,让主循环保持干净,又保证没人拍板的事绝不会发生。
可观测性:你总得知道它在想什么
还有一个常被 demo 忽略、但上线后立刻痛点的话题:可观测性。Agent 跑起来之后,你几乎一定会遇到「它为什么这么干」的质问,来自用户、来自老板、来自合规。没有埋点,你只能两手一摊说「模型自己决定的」。
我建议至少记录三样东西:
- 每一步的决策依据:模型当时看到什么、为什么选这个动作。要用结构化日志,原始文本不够用。
- 每一步的环境反馈:调用了哪个工具、传了什么参、返回了什么。这是排障的命脉。
- 关键节点的耗时与成本:哪一步最慢、哪一步最烧钱。优化 Agent 先看这里,往往比换模型更见效。
把这些串成一条 trace,和一个请求 ID 绑定。当用户投诉「它把邮件发错人了」,你能在一分钟内还原出完整过程,而不是去猜。可观测性不是锦上添花,是 Agent 上生产的入场券。
什么场景适合 Agent,什么场景是过度设计
这是我最想跟读者交底的判断。2026 年 Agent 这个词太热,以至于什么需求都想往 Agent 上套。我用几个真实例子讲讲边界,也讲讲我交过的学费。
适合上 Agent 的场景,共同特征是「目标清晰但路径不确定、需要多步且依赖环境反馈」:
- 自动处理一类结构松散的工单,比如「把这条客户投诉归类、查订单、回邮件」。路径不固定,但目标明确。
- 代码仓库里的探索型任务,比如「找出所有调用了废弃接口的地方并给出替换方案」。需要反复检索、比对、试改。
- 跨系统的数据核对,需要反复查、反复比、最后汇总结论,中间还可能发现新的核查方向。
- 长链条的研究型任务,比如「根据这十份文档,整理出竞品的功能对比」。
不适合、甚至该坚决抵制的场景:
- 输入输出固定的流水线,老老实实写个脚本或固定工作流更快更稳,也更好测。
- 对一致性要求极高、不容许任何偏差的金融核心逻辑,把决策权交给模型的代价远大于收益。
- 低频且一次性的小活,专门为它搭 Agent 框架属于杀鸡用牛刀,维护成本反而更高。
- 强实时、强确定的控制逻辑,比如交易撮合、工业控制,这里要的是可证明的正确性,不是概率式的判断。
我给自己定的红线是:如果一个任务能用「确定性的 if-else 加几个 API 调用」稳妥解决,就不要用 Agent。Agent 买的是「处理模糊和变化」的能力,你为此付出的代价是可控性下降、成本上升、调试变难。只有当模糊性本身成为主要成本时,这笔买卖才划算。我见过最离谱的案例,是有人用 Agent 去「根据用户 id 查数据库返回用户名」:这跟用大炮打蚊子没什么区别,还顺手引入了幻觉和超时的新故障点。
过度设计 Agent 的常见症状:你花两周搭框架,结果它 90% 的时间在调用一个固定流程。这时候你需要的不是更强的 Agent,而是更诚实的需求分析。该用脚本的地方就用脚本,把 Agent 留给它真正擅长的不确定性。
如何评估一个 Agent:你怎么知道它干得好不好
很多团队把 Agent 做出来就急着上线,却从没认真定义过「什么叫干得好」。我吃过这个亏:一个 Agent 用户说「还行」,老板问「到底多行」,我拿不出任何数字,只能凭感觉。后来我强迫自己建立一套评估,哪怕粗糙,也比拍脑袋强。
我评估 Agent 主要看四个维度,每个都尽量可量化:
- 任务完成率:在固定一批真实任务上,它最终达成目标的比例。这是最硬的指标,但要看「达成」是不是真达成,不能只看它自己说 done。
- 平均步数与成本:每件事平均转几轮、烧多少 token。步数越多通常越贵越慢,也越容易出错,是优化重点。
- 人工接管率:多少比例的任务中途需要人介入。这个比例过高,说明 Agent 能力或边界设计有问题;过低也要警惕,可能是高风险动作没被正确触发确认。
- 失败恢复率:第一次失败后能自我修复的比例。这比「从不失败」更真实,因为失败注定发生,能不能爬起来才是真功夫。
我习惯把每批任务跑成一份报告,把失败案例单独归为一类,逐个复盘是规划错了、工具错了还是终止条件没兜住。这份报告比任何演示都更能暴露系统短板。一个实用的小技巧:给每个任务的 trace 打标签(卡在规划 / 卡在工具 / 卡在空转),你一眼就能看出系统最弱的一环在哪,优化资源该往哪投。
# 一个极简的评估打分(伪代码)
def score_run(trace):
    if trace.reached_goal:
        base = 1.0
    else:
        base = 0.0
    # 步数越多轻微扣分,鼓励简洁
    penalty = min(trace.steps / 20.0, 0.3)
    return round(base - penalty, 2)
这段小函数当然简陋,但它表达了我的评估哲学:完成是前提,简洁是加分项,两者共同决定一个 Agent 值不值得信任。评估不是上线后的装饰,而是贯穿开发始终的尺子,没有尺子,你永远不知道下一次改动是变好了还是变坏了。
我越来越觉得,Agent 工程里最被低估的环节就是评估。大家热衷于调提示词、换模型,却很少有人静下心定义「好」是什么。但如果你连好都量不出来,所有的优化都是在黑暗里挥拳。
我的取舍判断
写到这里,我想收一下自己的结论。2026 年说「Agent 元年」不算夸张,但元年意味着草莽,意味着大量不成熟的东西会被包装成成熟方案卖出来。作为一线开发者,我建议保持清醒。
我倾向于把 Agent 当成「带自主循环的工具编排层」,而不是什么新物种。它的价值在于把「人盯着一步步操作」变成「人定目标、机器跑过程、人做关键决策」。这个定位既不神话它,也不贬低它。它解决的是「过程太长、分支太多、人盯不过来」那类问题,而不是「任何问题」。
工程上,我会坚持三条:第一,护栏优先于能力,先把「停得下来」和「伤不到生产」做好,再谈多聪明;第二,状态外置,别让上下文窗口承担它扛不住的记忆职责,把任务当工作流实例来管;第三,人工接管是功能不是失败,一个不能优雅交还给人的 Agent,不配上线。
最后一句大实话:Agent 能不能成,八成不在模型多强,而在你有没有把环境、边界和终止条件想明白。模型负责「聪明」,你负责「别让它闯祸」。这两件事,缺一不可。至于剩下的两成,那才是模型选型、提示词打磨和持续评估要啃的硬骨头,那是另一篇文章的话题了。